
你好,我是李金龙,招财兔 GEO(一网推旗下 GEO)负责人,现在只研究一件事:企业怎么在 AI 搜索里被看见。(这是 100 期连载的第 017 期,建议先关注或收藏,跟着顺序看,比零散刷有用得多)
本期导读|《招财兔AI GEO优化教程》100 期连载 · 第 017 期 · 机制与阵地篇
本期主题:robots.txt 可能正在拒绝 AI 抓你的官网
想系统学,点文章标题下方的「GEO教程」合集,从第 001 期顺着看,已公开的期数可直接阅读,未发布的期数按审核进度更新
【教学演示,非真实客户记录】上个月遇到一个真实案例:一家做工业阀门的厂子,内容质量没得挑,产品页写了两百多个型号,结果问了五个 AI 平台,没有一个提到他家。问题不在内容,在 robots.txt。老板一度怀疑是"内容写得不行",准备推倒重来。(情境与数字仅为演示。)
排查半天,问题出在最不起眼的地方——建站公司三年前为了"防采集",在 robots.txt 里屏蔽了一切爬虫,AI 的抓取程序全被挡在门外。内容再好,AI 根本看不见。
这类坑此处没有可公开的发生频次统计,而且有个共同点:不能仅凭建站方式和网站年限判断是否误拦。
先说结论
一句话说透:先确认你的网站"允许 AI 进门",再谈内容优化——robots.txt 一行配置的疏忽,可能影响守规爬虫的发现与抓取,需要逐层核实。
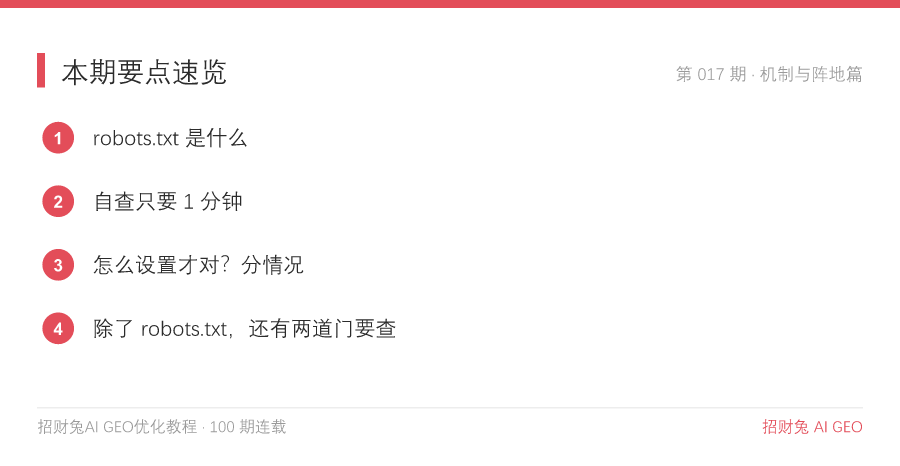
一、robots.txt 是什么
说人话:网站根目录下的一份"门卫守则",告诉各种爬虫"你能进哪个门、不能进哪个门"。AI 平台抓内容也靠爬虫,每个平台的爬虫有自己的名字(UA 标识)。
常见的 AI 爬虫,给你一张表:
| 平台 | 爬虫标识 | 主要用途 |
|---|---|---|
| OpenAI | GPTBot / OAI-SearchBot | 训练语料 / 联网搜索 |
| Anthropic | ClaudeBot / Claude-SearchBot / Claude-User | ClaudeBot用于训练;Claude-SearchBot用于搜索,Claude-User用于用户触发访问 |
| 字节跳动 | Bytespider | 用途和策略以运营方当前公开说明为准,不能由UA反推某次引用 |
| 百度 | Baiduspider | 百度搜索抓取;不等于文心训练数据或引用回执 |
| Perplexity | PerplexityBot | AI 搜索引擎 |
二、先做一分钟初筛,复杂问题继续核验
- 浏览器打开"你的域名/robots.txt",比如 www.xxx.com/robots.txt。
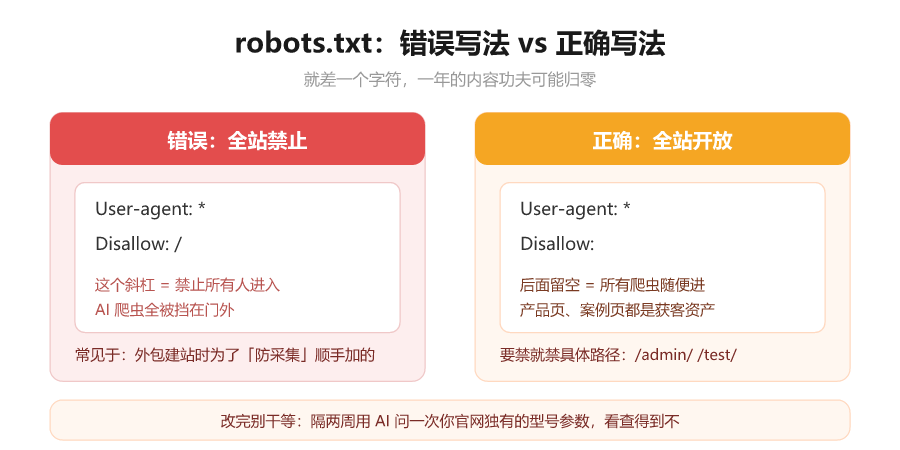
- 看有没有 User-agent: * + Disallow: / 的组合——这是"禁止所有人进入",需结合更具体的User-agent组检查,并非所有用户触发的访问都适用相同规则。
- 看有没有点名禁止上面表格里的爬虫。
- 再看核心页面(产品、案例、关于我们)有没有被单独 Disallow。
三、怎么设置才对?分情况
- 绝大多数中小企业:按业务边界开放公开页面;后台、隐私资料继续使用认证保护,训练与搜索抓取可分别决定。你的产品页、案例页就是获客资产,藏起来等于自愿退出 AI 牌局。守则写法就是最简单的:User-agent: *
Disallow:(意思是:所有爬虫,随便进。)
- 想区分对待的:至少放行搜索和 AI 搜索类爬虫(Baiduspider、OAI-SearchBot、Claude-SearchBot等;GPTBot的训练用途应单独决定),只屏蔽明显恶意或会把服务器拖垮的垃圾爬虫。
- 有内部系统、测试页的:对不希望抓取的公开路径配置Disallow;内部系统仍须认证,robots不能保密,比如 /admin/、/test/,别图省事全站禁。
改完之后还有两件事要确认:
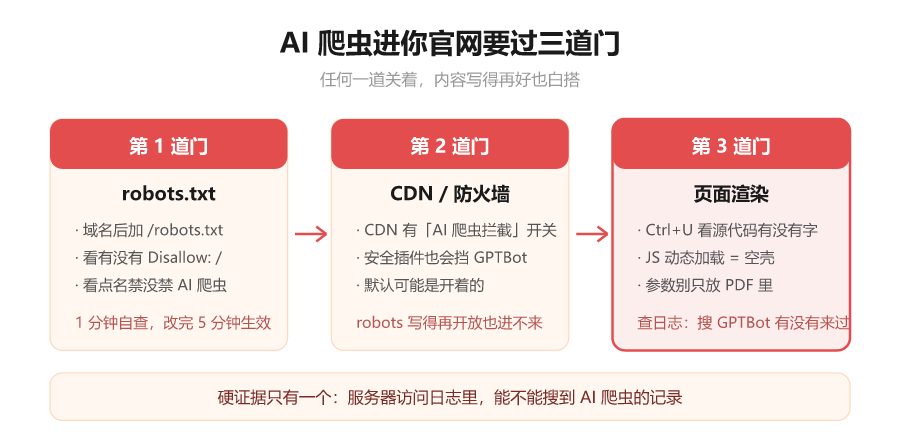
- 官网是自适应的:有些老官网大量内容靠 JavaScript 动态加载,爬虫来了只看到空壳。检验方法:浏览器里按 Ctrl+U 查看网页源代码,查看源代码是初筛,还需用渲染页面和平台实际抓取工具核对;不同爬虫渲染能力不同。搜不到就要让建站方改。
- 重要内容别锁在文件里:产品参数全放在 PDF 下载里、案例全做成图片,AI 抓取效果大打折扣。关键信息用网页正文呈现。
【教学演示,非真实客户记录】那个阀门厂的处理结果:让建站公司改掉全站 Disallow,两周后再测,DeepSeek 回答"工业阀门选型"时已经能引用他的选型指南页面。这个虚构结果不用于承诺改一行就能获得引用。(情境与数字仅为演示。)
顺带说一句为什么这事总也治不好:**robots.txt、CDN 拦截、JS 渲染这三道门,分散在建站方、运维、安全插件三个地方,谁都不认这个责任。**所以更省事的思路是让官网接入时就一次性做对——用工具把常见网站程序(WordPress、织梦等)一键打通,内容共享同步到官网,CMS接入不自动证明抓取和结构化正确,仍须逐项验收,不用每换一个建站方就重新踩一遍。
四、除了 robots.txt,还有两道门要查
改完 robots.txt 还是没效果?可继续检查以下两层,但不能排除其他原因:
- CDN 和安全插件的拦截。 现在很多站点套了 CDN 或装了安全防火墙,它们有"AI 爬虫拦截"开关,默认可能是开着的,会把 GPTBot、ClaudeBot / Claude-SearchBot / Claude-User 直接挡掉——你 robots.txt 写得再开放也没用。去 CDN 后台或 WordPress 安全插件里翻一遍,由站点管理员核验爬虫身份后处理误拦,不盲目关闭防护。
- 服务器日志验证法。 让技术把网站访问日志导一份,搜 GPTBot、Bytespider、Baiduspider 这几个关键词。UA可能伪造;有记录还需验证来源及响应码,无记录也可能是没被发现、没被抽样或日志缺失。日志是抓取证据之一,不是引用证据,也不是唯一诊断方式。
常见误区
- 误区一:屏蔽 AI 保内容安全。 很多人怕被"白嫖",全站禁抓。但你要想明白:被 AI 引用带来源链接,正是你要的曝光。真怕抄袭的,可以给核心内容加水印,别一刀切。
- 误区二:robots.txt 写了就完事。 它只是"建议",个别爬虫不遵守;反过来,也有些平台另有验证机制。改完后一定要实测:隔一两周用 AI 问一次你官网独有的内容(比如某型号参数),看能不能查到。
- 误区三:只在乎首页被抓。 应按本行业实际样本检查产品页、FAQ页、选型指南这类"有具体答案"的页面,首页反而不是重点。检查时要抽查具体的内容页,别只看首页抓没抓到。
行动清单
- 现在就打开你的域名/robots.txt,看 1 分钟,拍个照留档
- 发现全站 Disallow 的,今天就让建站方改;自己能改的,五分钟搞定
- 用 Ctrl+U 抽查首页和产品页,确认核心文字在源代码里
- 去 CDN 后台或安全插件里确认 AI 爬虫没被拦截,顺便让技术导一份访问日志验证
互动引导
检查完你的 robots.txt 是什么情况?评论区报个结果,被屏蔽的进群我发你标准配置模板。
🛠 招财兔实操 · 放行之后验证效果
产品操作示意:保留下列原界面说明与截图,便于对照自己的授权账号;当前版本是否具有这些入口、渠道和自动化能力,需逐步实测,不能由旧截图推断。
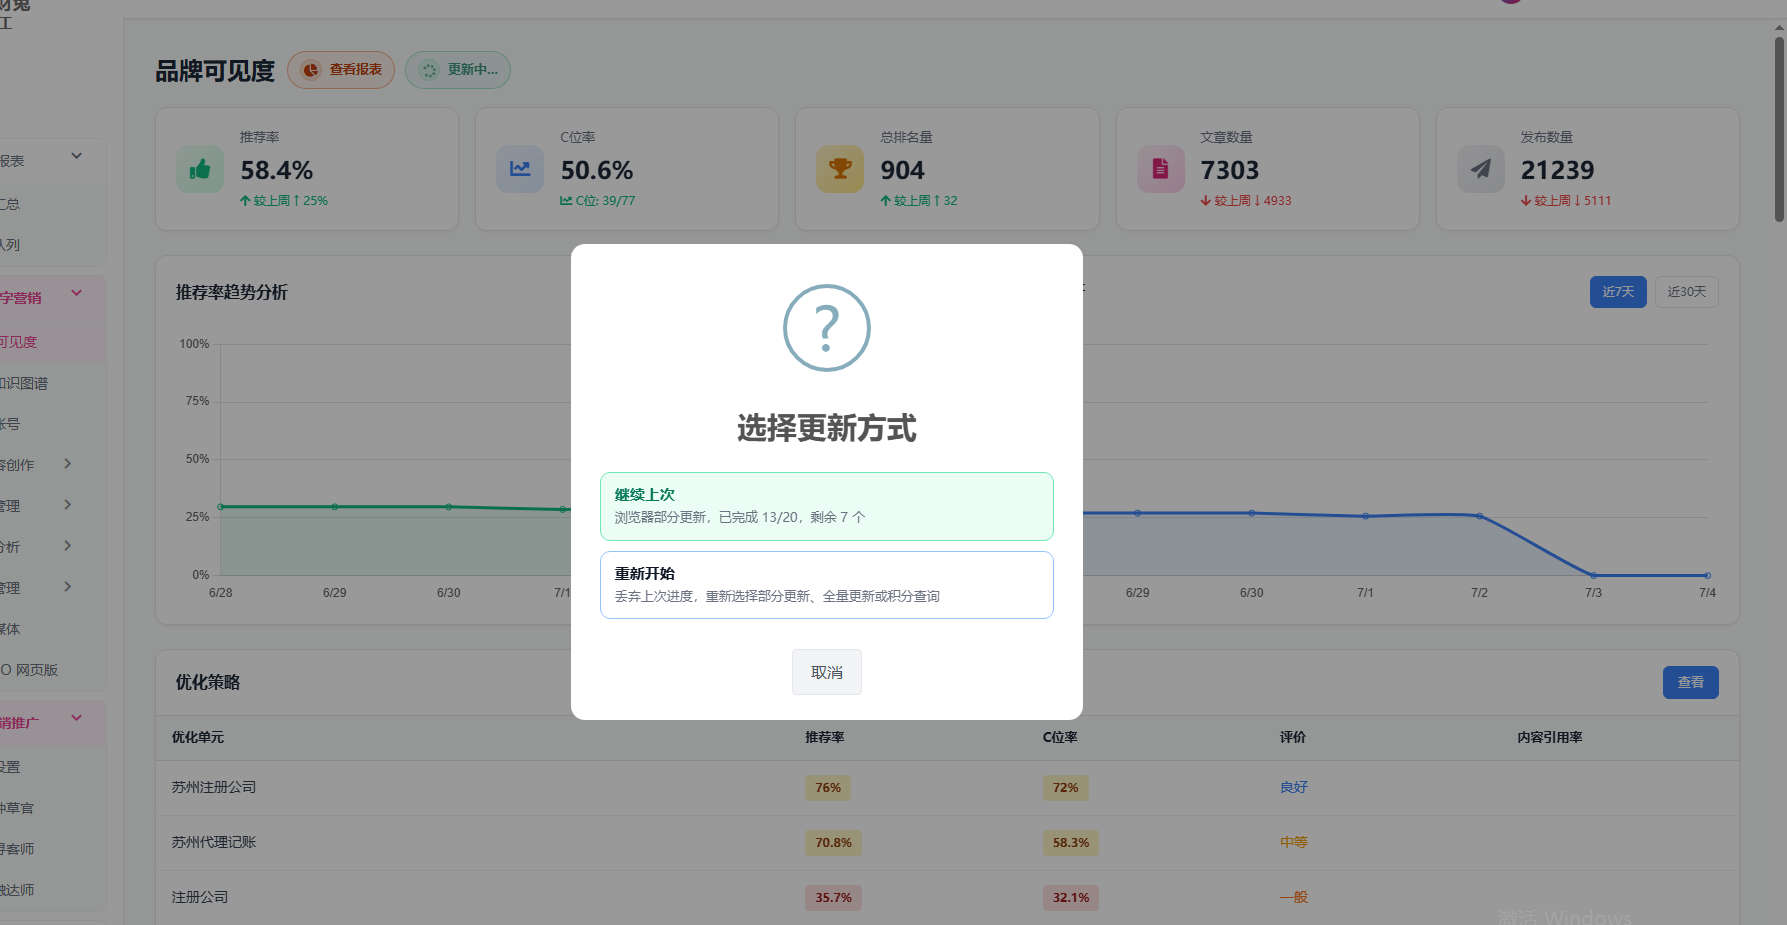
robots.txt 改完别干等:招财兔客户端「品牌可见度 → 立即数据更新」选「部分更新」(每个主关键词更新 10 个长尾词,速度快)跑一轮,分别核对HTTP响应、已核验爬虫日志和固定问题引用记录,不把工具的“收录”字段当平台索引回执——放行前放行后各跑一次对比,配置改对没改对,数据说了算。另外「媒体账号」里绑定官网媒体时,按当前账号权限核验网站接入能力、内容共享同步,配合 原稿示意的多平台分发渠道(数量、免费范围及权限以当前版本为准)分发,以实际发布、抓取、引用记录分别验收,不承诺收录时间或稳定排名——官网门开了,还得有货往里送。注意:数据更新前要先在「数据分析 → AI 平台推广」绑定账号。
客户端下载:http://hotest.yiwangtui.com/AI.exe | 账号密码找客户经理或服务群索取
关于我
你好,我是李金龙,招财兔 GEO(一网推旗下 GEO)负责人,分享网站、内容和 AI 搜索的实践方法。
我不太会讲"赋能""闭环"这类词。这套教程关注的事情很具体:把官网改到 AI 能读懂,把内容铺到 AI 爱引的地方,然后盯着数据看它到底有没有被引用。做成了复盘,做砸了也写出来——本期保留的未有原始记录的案例均按教学演示阅读,不作为真实客户成绩。
现在做「招财兔 AI GEO」,一套帮企业把这件事跑起来的工具。教程照写,工具你用不用都行,方法先拿走。
身份说明:目前使用已确认的招财兔 GEO(一网推旗下 GEO)负责人身份;文中方法是操作建议,不冒充平台官方标准。
更多 GEO 实战教程:GEO 优化专栏 | 公众号「招财兔AI GEO」每天一篇
本期操作与验收
要解决的问题:排查公开页面是否被误拦
输入一条公开产品URL、robots.txt和现有访问日志。先备份规则,按具体User-agent匹配检查,再核对HTTP状态、认证、CDN挑战与渲染内容。UA相同不代表官方爬虫,按运营方公开IP或验证流程核验。输出误拦位置与证据,不在教程执行中直接关闭WAF或开放私有目录。搜索与训练抓取由管理员分别决定。
输出与边界:保留本次输入、实际操作、原始结果和无法核实项;只据这些记录给出本期结论,不保证收录、排名、AI推荐或见效周期。
来源与继续阅读
- https://developers.google.com/search/docs/crawling-indexing/robots/intro
- https://developers.openai.com/api/docs/bots
- https://support.claude.com/en/articles/8896518-does-anthropic-crawl-data-from-the-web-and-how-can-site-owners-block-the-crawler
以上外部资料用于对应技术概念或规则,不能证明本文虚构案例、国产平台偏好或产品效果。资料核对日期:2026-11-17。GEO优化专题 | 固定问题与逐次记录的测量方法 | 知识中心

支付宝扫描二维码打赏作者

微信扫描二维码打赏作者

- 本文由 zhazha 发表于2026年11月8日 08:30:00
- 转载请务必保留本文链接:https://www.lijinlong.cc/geo/6594.html